Д.В. Беляков, М.И. Зуев, А.А. Кокорев, Д.И. Пряхина, С.С. Филиппов
Вычислительные кластеры являются многопользовательскими системами, где на счётных узлах параллельно выполняются разнородные задачи [1]. Планировщик задач статически резервирует запрошенные вычислительные узлы, ядра процессора и объём оперативной памяти на весь период работы задачи [1, 2]. В условиях гетерогенной загрузки часть процессорных ядер выделяется задаче на уже частично занятых узлах, а другая часть — на свободных ресурсах. В зависимости от специфики расчётного алгоритма и фоновой занятости узлов отдельные вычислительные процессы и нити завершают вычисления раньше остальных. Это приводит к ситуации, когда ресурсы на узлах не используются, но остаются зарезервированными определенной задачей до момента её завершения.
Научные расчёты обладают свойством повторяемости. Пользователи регулярно запускают схожие расчётные сетки, параметрические исследования и численные симуляции. Свойство повторяемости позволяет использовать профили потребления ресурсов предшествующих запусков для оптимального планирования последующих задач, что делает актуальной разработку системы для автоматического выявления потерь и формирования рекомендаций адаптированных квот ресурсов.
Для проведения исследования развернута экспериментальная среда на базе Гетерогенной вычислительной платформы HybriLIT [3]. В среде из 7 виртуальных машин функционирует фоновый сбор метрик, в качестве тестовой нагрузки используются программы на языках C, C++ и Fortran, реализующие алгоритмы сеточных расчётов, численного интегрирования и моделирования физических процессов. На виртуальных машинах установлены: операционная система AlmaLinux 9.6, планировщик задач Slurm 25.11 [2], среда OpenMPI 5.0.9 с интерфейсом PMIx 5.0.10 и файловая система Lustre под управлением ZFS. Ограничение ресурсов выполняется механизмом контрольных групп (cgroups v2) операционной системы при обязательной изоляции и ограничении процессорных ядер и оперативной памяти [4].
Сбор характеристик для запускаемых в Slurm задач ориентирован на создание профиля конкретной задачи и предоставляет ограниченный набор метрик. Для сбора телеметрии будет применяется инструментарий Performance Co-Pilot (PCP) [5]. Система PCP будет осуществлять непрерывное наблюдение за вычислительными узлами, фиксируя метрики ядра, механизма контрольных групп (cgroups v2) и аппаратных счётчиков мониторинга производительности (Performance Monitoring Unit, PMU) до запуска задачи, во время её выполнения и завершения.
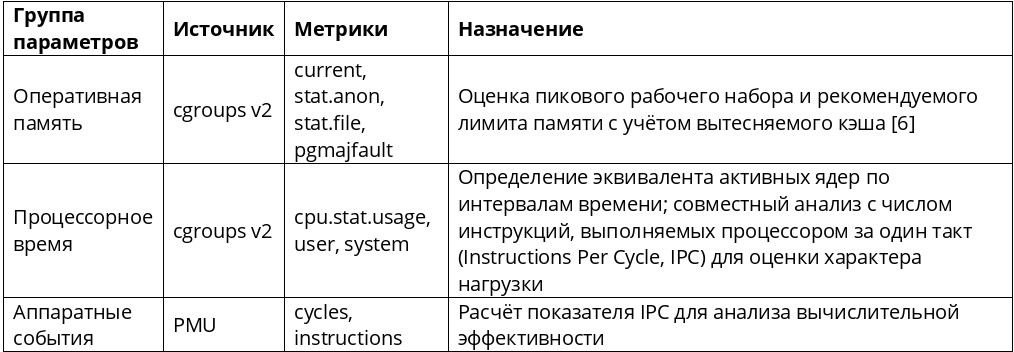
Все данные телеметрии будут разделены на три группы (см. табл. 1).
Таблица 1. Группы собираемых метрик
Архитектура разрабатываемой системы представлена на рисунке 1.
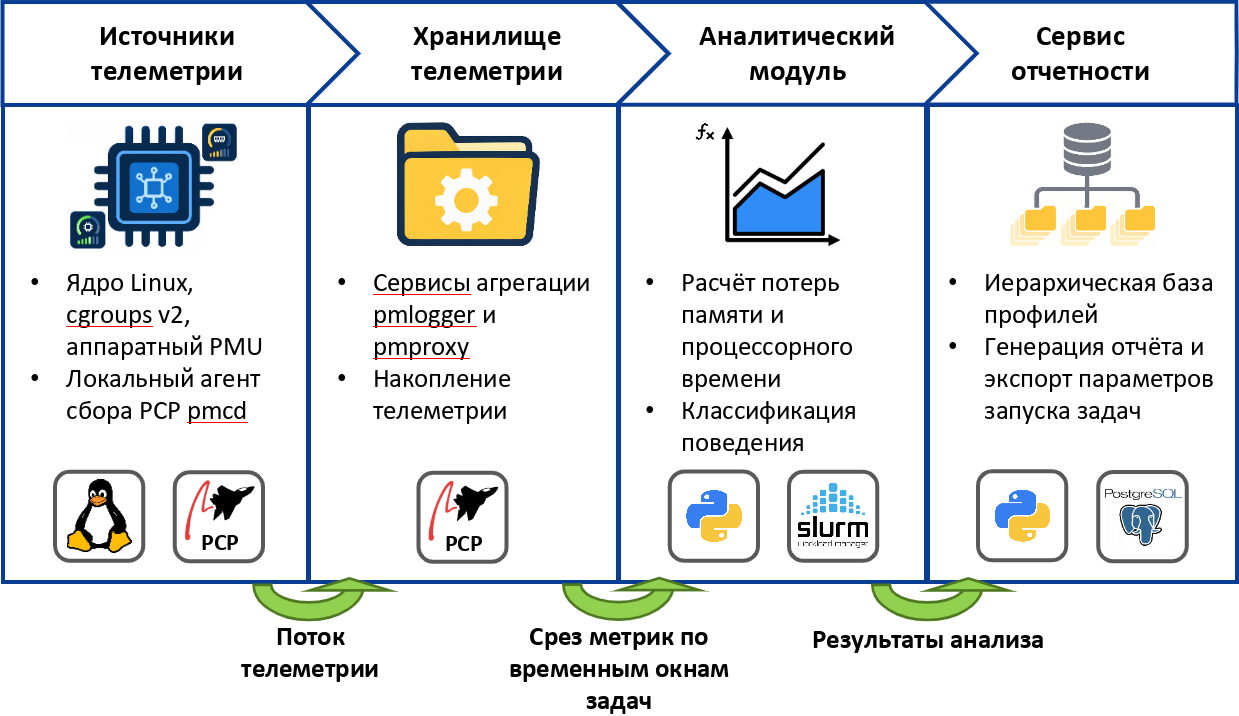
Рисунок 1. Архитектура потоков данных и компонентов системы
На уровне источников телеметрии локальный агент PCP pmcd (performance metrics collector daemon) опрашивает подсистему cgroups v2 и модуль PMU вычислительных узлов, которые формируют системные показатели выполнения процессов. Поток телеметрии направляется в хранилище, где сервисы агрегации pmlogger и pmproxy осуществляют непрерывное накопление показателей во временные ряды для долговременного хранения истории работы кластера.
Аналитический модуль на языке Python будет извлекать срез метрик из временных рядов по каждой задаче из планировщика. Каждой успешно завершенной задаче [7] модуль будет присваивать вектор идентификации, основанный на: признаках исполняемой программы, идентификаторе пользователя, количестве используемых узлов, аргументах запуска и параметрах окружения. После обработки полученных данных модуль будет формировать результаты анализа включающие, оценку эффективности использования памяти и процессорного времени, а также классификацию поведения задачи.
Полученный вектор идентификации и результаты анализа будут сравниваться с профилями ранее выполненных задач ближайшего уровня иерархии из базы данных. На основе обновленных исторических данных будут рассчитываться адаптированные параметры запуска, охватывающие два ключевых вычислительных ресурса: оперативную память и процессорные ресурсы. После чего отчёт по задаче будет сохраняться в рабочем каталоге и направляться пользователю по электронной почте [8].
Методология испытаний предусматривает перенос экспериментов на согласованное количество узлов суперкомпьютера «Говорун» [9].
План экспериментальной проверки включает следующие шаги:
- Проведение серии запусков научных программ с пользовательскими квотами для снятия базового профиля.
- Проведение тестов на свободных узлах, частично занятых узлах и в условиях конкуренции с монопольными задачами.
- Формирование адаптированных конфигураций и расчёт разницы зарезервированных и реально использованных гигабайт-часов и ядро-часов.
Результаты работы [10] доложены на 31-й международной конференции «Всероссийская научно-практическая конференция студентов, аспирантов и молодых специалистов (с международным участием)» 06–10 апреля, 2026 г., Дубна, Россия.
Список источников
- Nikitenko D.A. et al. Supercomputer application integral characteristics analysis for the whole queued job collection of large-scale HPC systems // Параллельные вычислительные технологии (ПаВТ’2016). — 2016. — С. 20–30.
- Jette M., Grondona M. SLURM: Simple Linux Utility for Resource Management // ClusterWorld Conference and Expo. — Lawrence Livermore National Laboratory, 2003 [Электронный ресурс]. URL: https://slurm.schedmd.com/slurm_design.pdf (дата обращения: 20.05.2026).
- Anikina A., et al. Structure and Features of the Software and Information Environment of the HybriLIT Heterogeneous Platform // Vishnevsky V.M., Samouylov K.E., Kozyrev D.V. (eds.) Distributed Computer and Communication Networks. DCCN 2024. Lecture Notes in Computer Science, vol. 15460. Cham: Springer, 2025. С. 444–457. DOI: 10.1007/978-3-031-80853-1_33.
- Linux cgroups(7) manual page [Электронный ресурс]. URL: https://man7.org/linux/man-pages/man7/cgroups.7.html (дата обращения: 27.05.2026).
- Performance Co-Pilot (PCP) [Электронный ресурс]. URL: https://pcp.io/ (дата обращения: 27.05.2026).
- Linux Kernel Organization. Cgroup Memory Controller Documentation [Электронный ресурс]. URL: https://docs.kernel.org/admin-guide/cgroup-v1/memory.html (дата обращения: 22.05.2026).
- SchedMD. Slurm Job Exit Codes Documentation [Электронный ресурс]. URL: https://slurm.schedmd.com/job_exit_code.html (дата обращения: 24.05.2026).
- Plazonic J., Halverson J. Job Monitoring and Efficient GPU Cluster Utilization with Jobstats. Princeton Research Computing [Электронный ресурс]. URL: https://researchcomputing.princeton.edu/sites/g/files/toruqf7796/files/documents/ncar_jobstats_april_2026.pdf (дата обращения: 20.05.2026).
- JINR. SUPERCOMPUTER «Govorun» [Электронный ресурс]. HybriLIT, 2023–2026. Режим доступа: http://hlit.jinr.ru/en/supercomputer_govorun_eng/ (дата обращения: 24.05.2026).
- Филиппов С.С., Беляков Д.В., Зуев М.И., Кокорев А.А., Пряхина Д.И. Методы и программная архитектура выявления неэффективно используемых ресурсов в суперкомпьютерных средах // 31-я Всероссийская научно-практическая конференция студентов, аспирантов и молодых специалистов (с международным участием) (г. Дубна, 6–10 апреля 2026 г.) : сборник материалов / под общ. ред. А. Н. Воропая. — Дубна : Государственный университет «Дубна», 2026. — С. 88–90.